Porównanie · · 7 min czytania
Który poziom wysiłku wybrać w Claude Fable 5.2? Koszt, czas i tokeny z 41 naszych testów
Jeden brief, pięć poziomów wysiłku: od 1,35 USD i około 5 minut na low do 9,09 USD i ponad 37 minut na max. Na podstawie 41 naszych testów pokazujemy koszt, czas i tokeny każdego poziomu w Claude Fable 5.2 i porównujemy nowy model z Fable 5.1.
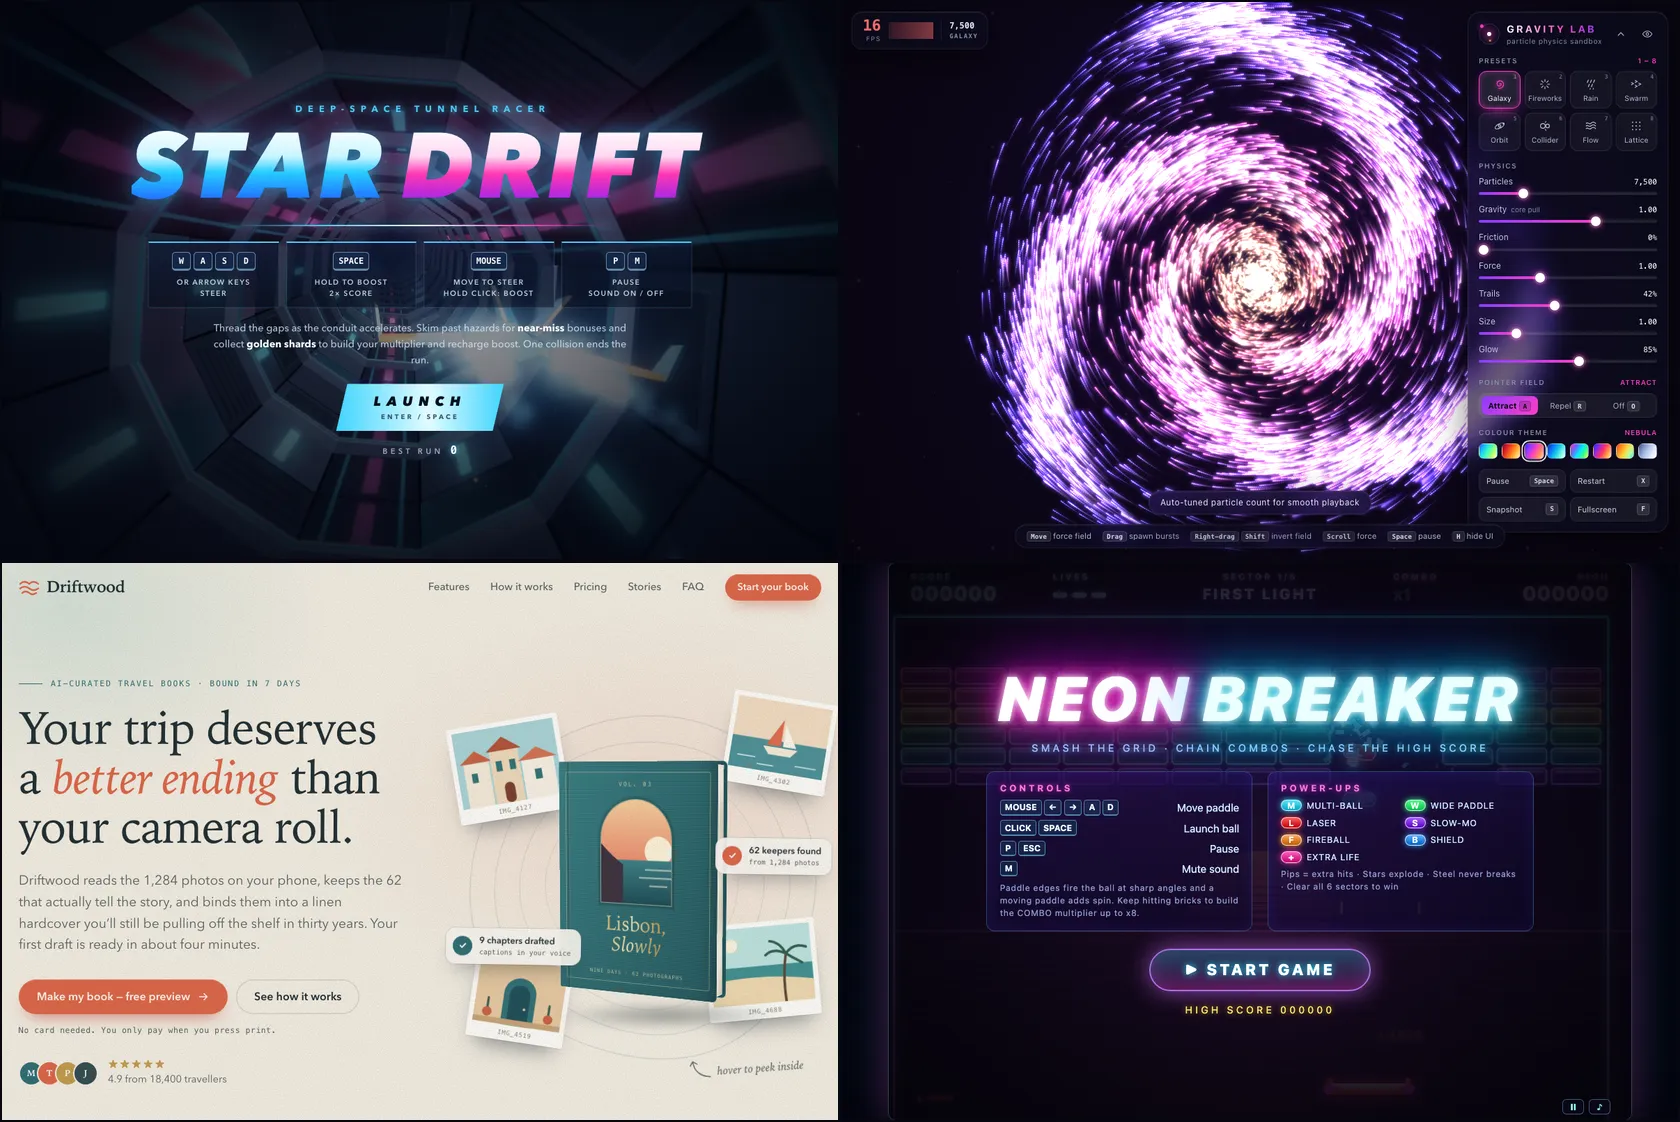
W skrócie: w Claude Fable 5.2 poziom wysiłku (effort) mocno zmienia koszt i czas odpowiedzi. Ten sam landing page kosztował 1,35 USD i powstał w 5 min 4 s na low, a na max 9,09 USD i 37 min 34 s. Na tym briefie Fable 5.2 napisał więcej tokenów niż Fable 5.1 na każdym poziomie, a na high około 4 razy więcej. Jeśli pracujesz na Fable, zacznij od medium, domyślnego poziomu w Claude Code, i podnoś wysiłek świadomie: na tych samych briefach max kosztował od 3 do 10 razy więcej niż low.
Wszystkie wyniki, każdy z kosztem, czasem i liczbą tokenów, otworzysz obok siebie na testingmodels.com/pl/fable-5-2.
Jak mierzyliśmy
Serwis testingmodels.com prowadzi Patryk Raba, ten sam wydawca co vibecoding.pl, więc to nasze własne testy. Fable 5.2 zmierzył się tam z 21 wyzwaniami, od landing page i gry przez emulator CHIP-8 i symulację płynów po szachy. Część z nich puściliśmy na kilku poziomach wysiłku, stąd 41 wyników.
- Jeden przebieg na zadanie i poziom (n=1). Każde wyzwanie na danym poziomie uruchomiliśmy raz przez Claude Code CLI, z flagą --effort ustawianą osobno dla każdego przebiegu, bez dostępu do narzędzi i bez wybierania lepszych prób.
- Te same briefy dla każdego modelu. Fable 5.2 dostał dokładnie te polecenia, które dostały wszystkie modele testowane na testingmodels.com.
- Koszt według cennika API. To wycena przebiegu po stawkach 8 USD za milion tokenów wejściowych i 40 USD za milion wyjściowych, tak jak podaje ją CLI. Same testy szły w ramach subskrypcji, więc dolary są równowartością, a nie rachunkiem.
- Czas i tokeny. Czas to czas zegarowy generowania. Tokeny to tokeny wyjściowe razem z tokenami myślenia (thinking).
- Bez poprawek. Każdy wynik publikujemy dokładnie tak, jak napisał go model.
Łącznie wyszło 198,48 USD według cennika API, 4 736 435 tokenów wyjściowych i 12,7 godziny generowania. Pełny opis metody znajdziesz w metodologii Testing Models.
Wyniki: koszt, czas i tokeny na każdym poziomie
Jeden brief, pięć poziomów wysiłku
Najpełniejsze porównanie daje brief Driftwood, czyli landing page fikcyjnego SaaS-a do tworzenia fotoksiążek z podróży. Środowisko i polecenie są te same, zmienia się tylko poziom wysiłku:
- low: 1,35 USD, 5 min 4 s, 33,6 tys. tokenów
- medium: 2,08 USD, 7 min 58 s, 51,5 tys. tokenów
- high: 4,72 USD, 18 min 38 s, 117,7 tys. tokenów
- xhigh: 9,07 USD, 27 min 46 s, 175,2 tys. tokenów
- max: 9,09 USD, 37 min 34 s, 226,5 tys. tokenów
Na górze drabinki xhigh i max kosztowały prawie tyle samo, ale przebieg na max trwał 37 min 34 s zamiast 27 min 46 s i dał 226,5 tys. tokenów zamiast 175,2 tys. Kwota z CLI obejmuje też koszt po stronie wejścia, więc nie musi rosnąć równo z tokenami wyjściowymi.
Średnie ze wszystkich 41 wyników układają się podobnie (low 1,87 USD, high 5,20 USD, max 9,73 USD), ale każda obejmuje inny zestaw zadań, więc lepiej porównywać ten sam brief.
Na tym samym briefie max kosztował od 3,1 do 10,3 raza więcej niż low: landing page 6,7 raza, gra 4,6, narzędzie 7,6, dashboard 5,2, cząsteczki 5,9, emulator CHIP-8 10,3, serwis informacyjny 4,0, digger 3,1. Czas rósł mniej więcej w tym samym tempie, od 3,2 do 11,8 raza.
Fable 5.2 a Fable 5.1 na tym samym briefie
Brief Driftwood mamy też w wersji z Fable 5.1, poziom po poziomie. Nowy model na każdym poziomie napisał więcej tokenów i na każdym kończył później:
- low: 33,6 tys. wobec 27,4 tys. tokenów (+23%), 5 min 4 s wobec 4 min 53 s
- medium: 51,5 tys. wobec 26,5 tys. (+94%), 7 min 58 s wobec 4 min 55 s
- high: 117,7 tys. wobec 29,7 tys. (+297%), 18 min 38 s wobec 5 min 26 s
- xhigh: 175,2 tys. wobec 95,7 tys. (+83%), 27 min 46 s wobec 18 min
- max: 226,5 tys. wobec 144,3 tys. (+57%), 37 min 34 s wobec 30 min 16 s
Największa różnica wyszła na high: około 4 razy więcej tokenów i 3,4 raza więcej czasu. Na innych briefach, gdzie oba modele mają wynik na tym samym poziomie, Fable 5.2 też zawsze pisał więcej: na low od 1,3 do 2,4 raza więcej tokenów niż Fable 5.1, na high od 1,5 do 2,3 raza, a na max różnica była najmniejsza (gra: 216,0 tys. wobec 198,8 tys., dashboard: 216,3 tys. wobec 197,6 tys.).
W dolarach obraz jest inny i łatwo go źle odczytać. Na low Fable 5.2 wyszedł taniej (1,35 wobec 2,17 USD), choć napisał więcej tokenów. Nowy model ma o 20% niższe stawki: 8 i 40 USD za milion tokenów wejściowych i wyjściowych wobec 10 i 50 USD w Fable 5.1.
Do tego koszty Fable 5.1 raportowane przez CLI zawierają około 1,21 USD po stronie wejścia na przebieg, wobec 0,42 USD w Fable 5.2. Przy porównaniu modeli liczą się więc przede wszystkim tokeny. Nowy cennik i resztę zmian opisaliśmy w artykule o premierze Fable 5.2.
Fable 5.2 generuje też tokeny szybciej. Według naszego wyliczenia (tokeny wyjściowe podzielone przez czas zegarowy na briefie Driftwood) nowy model daje około 100 do 110 tokenów na sekundę, a Fable 5.1 około 80 do 94, czyli Fable 5.2 jest od 16 do 26% szybszy. To zgadza się z deklaracją Anthropic, że modele 5.2 generują odpowiedzi do 30% szybciej niż wersje 5.1. Czas zegarowy zawiera narzut, więc traktuj to jako przybliżenie.
Szybsze tokeny nie oznaczają jednak szybszej odpowiedzi: na tym samym poziomie Fable 5.2 kończył później, bo pisał więcej. Zestawmy to z tym, co Anthropic pisze w ogłoszeniu premiery (tłumaczenie nasze):
Przy wysiłku Medium (domyślnym w aplikacjach Claude i w Claude Code) Fable 5.2 potrafi wykonać wymagające zadania, zużywając mniej tokenów niż Fable 5.1.
Na naszym briefie, w jednym przebiegu, Fable 5.2 na medium napisał 51,5 tys. tokenów, a Fable 5.1 26,5 tys., czyli o 94% więcej. To obserwacja, a nie obalenie tezy Anthropic: jeden brief i jeden przebieg to za mało, a landing page nie musi być tym, co producent nazywa wymagającym zadaniem. Jeśli jednak przenosisz pracę z 5.1 na 5.2 bez zmiany poziomu, sprawdź zużycie tokenów na własnych zadaniach, zamiast zakładać, że spadnie.
Co to znaczy dla Twojej pracy
- Medium jako punkt wyjścia. To domyślny poziom w aplikacjach Claude i w Claude Code (Anthropic). Na briefie Driftwood kosztował 2,08 USD i trwał 7 min 58 s, a high już 4,72 USD i 18 min 38 s.
- High i wyżej to decyzja budżetowa. Na tych samych briefach max kosztował od 3 do 10 razy więcej niż low, a czas rósł podobnie. Podnoś poziom wtedy, gdy wynik z niższego Ci nie wystarcza, a nie z przyzwyczajenia.
- Na subskrypcji płacisz limitem. Dolary z tego tekstu nie trafią na Twój rachunek, ale tokeny i czas zostają te same. Anthropic podaje, że w tygodniu premiery subskrybenci kwalifikujących się płatnych planów dostają od jednego do trzech resetów limitu Fable, zależnie od stażu subskrypcji, a Fable może stanowić do 50% tygodniowego limitu użycia w planie Pro i na standardowych miejscach w planie Team. Driftwood na max to u nas 226,5 tys. tokenów wyjściowych, a na medium 51,5 tys., więc licz się z tym, że wysokie poziomy szybciej zbliżą Cię do limitu.
- Anthropic radzi zaczynać od Opus 5.5. Do większości zadań programistycznych i opartych na wiedzy producent zaleca start od Claude Opus 5.5, który nazywa swoim najmocniejszym modelem do codziennej pracy, i zmianę modelu w razie potrzeby, zależnie od zakresu i złożoności pracy. Nasze liczby dotyczą tylko Fable, więc tej rady nie weryfikujemy.
Czego te dane nie mówią
- Jeden przebieg. Każda liczba pochodzi z jednego uruchomienia (n=1), więc powtórka tego samego briefu może dać inny koszt i czas.
- Brak oceny jakości. Strona pokazuje koszt, czas i tokeny. Nie mówi, który poziom zrobił lepszy landing page, i nie twierdzimy, że wyższy wysiłek daje lepszy wynik.
- Nie wszystko działa. Emulator CHIP-8 na low i na max wyrzuca błąd przy ładowaniu, bo model zapisał błędne dane ROM w base64. Publikujemy oba wyniki tak, jak powstały, bez poprawek.
- Jeden przebieg powtórzony. Pierwszą próbę gry 3D na high przerwał limit użycia, zanim powstał jakikolwiek wynik, więc uruchomiliśmy ją ponownie. Strona oznacza ten wynik jako wygenerowany drugi raz.
Ocenę jakości zostawiamy Tobie. Na testingmodels.com/pl/fable-5-2 znajdziesz 41 wyników Fable 5.2 i otworzysz low, medium, high i max obok siebie, dokładnie w takiej postaci, w jakiej napisał je model. Zanim ustawisz wysiłek na stałe, zobacz, co dostajesz za każdy krok w górę.
Źródła: Anthropic: Introducing Claude Fable 5.2 and Claude Mythos 5.2, testingmodels.com/fable-5-2, testingmodels.com/method.